
数据挖掘实验:关联规则分析之Apriori算法的实现
创始人
2025-05-28 04:25:09
一、实验原理
Apriori算法是第一个关联规则挖掘算法,也是最经典的算法。它利用逐层搜索的迭代方法找出数据库中项集的关系,以形成规则,其过程由连接(类矩阵运算)与剪枝(去掉那些没必要的中间结果)组成。该算法中项集的概念即为项的集合。包含K个项的集合为k项集。项集出现的频率是包含项集的事务数,称为项集的频率。如果某项集满足最小支持度,则称它为频繁项集。
二、实验内容
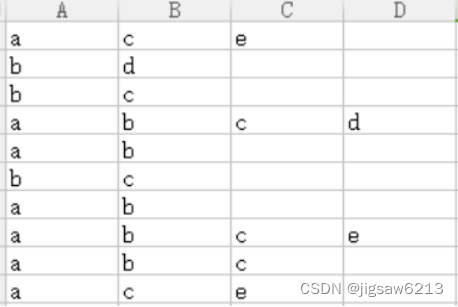
三、实验过程
python实现Apriori算法
from __future__ import print_function
import pandas as pd#自定义连接函数,用于实现L_{k-1}到C_k的连接
def connect_string(x, ms):x = list(map(lambda i:sorted(i.split(ms)), x))l = len(x[0])r = []for i in range(len(x)):for j in range(i,len(x)):if x[i][:l-1] == x[j][:l-1] and x[i][l-1] != x[j][l-1]:r.append(x[i][:l-1]+sorted([x[j][l-1],x[i][l-1]]))return r#寻找关联规则的函数
def find_rule(d, support, confidence, ms = u'--'):result = pd.DataFrame(index=['support', 'confidence']) #定义输出结果support_series = 1.0*d.sum()/len(d) #支持度序列column = list(support_series[support_series > support].index) #初步根据支持度筛选k = 0while len(column) > 1:k = k+1print(u'\n正在进行第%s次搜索...' %k)column = connect_string(column, ms)print(u'数目:%s...' %len(column))sf = lambda i: d[i].prod(axis=1, numeric_only = True) #新一批支持度的计算函数#创建连接数据,这一步耗时、耗内存最严重。当数据集较大时,可以考虑并行运算优化。d_2 = pd.DataFrame(list(map(sf,column)), index = [ms.join(i) for i in column]).Tsupport_series_2 = 1.0*d_2[[ms.join(i) for i in column]].sum()/len(d) #计算连接后的支持度column = list(support_series_2[support_series_2 > support].index) #新一轮支持度筛选support_series = support_series.append(support_series_2)column2 = []for i in column: #遍历可能的推理,如{A,B,C}究竟是A+B-->C还是B+C-->A还是C+A-->B?i = i.split(ms)for j in range(len(i)):column2.append(i[:j]+i[j+1:]+i[j:j+1])cofidence_series = pd.Series(index=[ms.join(i) for i in column2]) #定义置信度序列for i in column2: #计算置信度序列cofidence_series[ms.join(i)] = support_series[ms.join(sorted(i))]/support_series[ms.join(i[:len(i)-1])]for i in cofidence_series[cofidence_series > confidence].index: #置信度筛选result[i] = 0.0result[i]['confidence'] = cofidence_series[i]result[i]['support'] = support_series[ms.join(sorted(i.split(ms)))]result = result.T.sort_values(['confidence','support'], ascending = False) #结果整理,输出print(u'\n结果为:')print(result)return result
Apriori算法调用,进行关联性分析
from __future__ import print_function
import pandas as pd
from apriori import * #导入自行编写的apriori函数inputfile = '../data/menu_orders.xls'
outputfile = '../tmp/apriori_rules.xls' #结果文件
data = pd.read_excel(inputfile, header = None)print(u'\n转换原始数据至0-1矩阵...')
ct = lambda x : pd.Series(1, index = x[pd.notnull(x)]) #转换0-1矩阵的过渡函数
b = map(ct, data.as_matrix()) #用map方式执行
data = pd.DataFrame(list(b)).fillna(0) #实现矩阵转换,空值用0填充
print(u'\n转换完毕。')
del b #删除中间变量b,节省内存support = 0.2 #最小支持度
confidence = 0.5 #最小置信度
ms = '---' #连接符,默认'--',用来区分不同元素,如A--B。需要保证原始表格中不含有该字符find_rule(data, support, confidence, ms).to_excel(outputfile) #保存结果
四、实验结果
结果如下
support confidence
e—a 0.3 1.000000
e—c 0.3 1.000000
c—e—a 0.3 1.000000
a—e—c 0.3 1.000000
c—a 0.5 0.714286
a—c 0.5 0.714286
a—b 0.5 0.714286
c—b 0.5 0.714286
b—a 0.5 0.625000
b—c 0.5 0.625000
a—c—e 0.3 0.600000
b—c—a 0.3 0.600000
a—c—b 0.3 0.600000
a—b—c 0.3 0.600000
上一篇:深度学习——3D点云
相关内容
热门资讯
记者手记|时代大潮里的笃行与担...
来源:新华社记者手记|时代大潮里的笃行与担当新华社记者韩梁 朱瑞卿 伍岳9月的新德里草木葱郁,阳光热...
被骂 “君子之贼” 高若讷有点...
◎宋慧敏 北宋景祐三年(1036年)一个春日,谏官高若讷接到一封信,写信人是刚刚入朝任...
烂缦胡同:烟火气里涌动青春创业...
近日,在“全国文化中心建设巡礼”主题采访活动中,北京青年报记者走进北京市西城区牛街街道烂缦胡...
科技赋能实体 金融护航出海
9月9日至13日,2026年中国国际服务贸易交易会(以下简称服贸会)在北京首钢园举办,今年的...
湖北大学最新或2023(历届)...
1、考生自最新或2023(历届)4月1日起可在湖北大学招生信息网(http://zsxx.hub...